- El proyecto: en el mercado español, automatizar un proceso con IA cuesta entre 2.000 y 10.000 € de implantación; un asistente con los documentos de la empresa (RAG), entre 2.000 y 8.000 €; un agente que escribe en varios sistemas se presupuesta como software interno, entre 15.000 y 40.000 €.
- El uso del modelo: leer 1.000 facturas al mes cuesta entre 1,54 € y 36,29 € según el modelo, calculado con las tarifas oficiales de Google, OpenAI y Anthropic del 22 de septiembre de 2026.
- Lo que pesa de verdad es la revisión humana, la evaluación y el mantenimiento. Dos minutos de revisión por factura son 33 horas de trabajo al mes.
- Ayudas: Kit Consulting figura como convocatoria finalizada. No cuentes con ella sin comprobarlo en la fuente oficial.
El 21,1 % de las empresas españolas de 10 o más empleados usaba inteligencia artificial en el primer trimestre de 2025, según la encuesta de uso de TIC y comercio electrónico del INE publicada el 22 de octubre de 2025. Entre las de menos de 10 empleados, el 13,4 %. La siguiente pregunta es cuánto cuesta, y tiene dos partes: el proyecto, que se presupuesta por alcance, y la factura mensual del modelo, que es la única que se puede calcular al céntimo con fuentes públicas.
Este artículo da rangos de mercado para la primera y calcula la segunda. Los ejemplos llevan sus supuestos en tabla: cambia el tuyo y rehaz la cuenta.
Si lo que necesitas son los rangos de cualquier desarrollo (MVP, software interno, SaaS), están en cuánto cuesta un software a medida en España. Si aún no sabes si tu caso pide IA o una automatización clásica, empieza por agentes de IA en la empresa: cuándo compensan.
¿Cuánto cuesta implantar IA según el tipo de proyecto?
Rangos de mercado para un proveedor español que entrega código, pruebas y mantenimiento. La columna de uso del modelo sale de los cálculos de más abajo, con las tarifas oficiales del 22 de septiembre de 2026.
| Tipo de proyecto | Implantación (mercado) | Uso del modelo al mes (ejemplos de este artículo) | Mantenimiento y operación (mercado) |
|---|---|---|---|
| Automatizar un proceso con IA (clasificar correos, preparar informes) | 2.000-10.000 € | Depende del volumen; mismo cálculo que las facturas | 100-400 €/mes |
| Extraer datos de documentos o facturas | 2.000-10.000 € | 1,54-36,29 € por 1.000 facturas | 100-400 €/mes |
| Asistente con los documentos de la empresa (RAG) | 2.000-8.000 € | 3,14-77,12 € por 2.000 preguntas | 30-100 €/mes de infraestructura y 200-800 €/mes de operación |
| Agente que actúa en un solo sistema | 2.000-10.000 € | 4,35-108,87 € por 300 pedidos | 100-400 €/mes |
| Agente que escribe en varios sistemas | 15.000-40.000 € | Según pasos y volumen | 300-1.000 €/mes |
Los rangos de implantación y mantenimiento son los mismos que usamos en cuánto cuesta un software a medida y en RAG o fine-tuning para un asistente de empresa. Leer facturas es un caso de automatización de un proceso, por eso comparte fila de precio.
Por qué un agente no tiene rango propio
Un agente de IA es un modelo con un objetivo, herramientas para actuar sobre tus sistemas y reglas sobre qué puede hacer sin preguntar. Lo que mueve su precio es lo mismo que en cualquier software: cuántos sistemas toca, qué puede escribir en ellos, qué permisos necesita y cuántas pruebas hacen falta para dejarle tocar producción.
Un agente que registra pedidos en un único programa, con pocas herramientas y confirmación humana en lo irreversible, es una automatización con más estados: cae en la fila de 2.000-10.000 €. Uno que consulta el ERP, escribe en el CRM, manda correos y lleva registro de cada paso ya es un software interno, con su análisis, sus roles y sus pruebas. La etiqueta «agente» no cambia la cuenta; la cambian los sistemas y los permisos.
Cómo se controla un agente (permisos mínimos, validaciones antes de escribir, confirmación humana y registro) está en agentes de IA en la empresa.
El coste que casi nadie calcula: lo que gasta el modelo cada mes
Los proveedores de modelos cobran por token, un trozo de palabra de unos pocos caracteres. La tarifa va por millón de tokens y distingue entrada (lo que le mandas: instrucciones, documento, pregunta) y salida (lo que responde). En los modelos de esta tabla, la salida cuesta entre 5 y 8,3 veces lo que la entrada.
Tarifa estándar de pago, contexto corto, sin descuentos por lotes, en dólares por millón de tokens:
| Modelo | Proveedor | Entrada | Salida | Nota |
|---|---|---|---|---|
| GPT-5.6 Luna | OpenAI | 0,20 $ | 1,20 $ | |
| Gemini 3.5 Flash-Lite | 0,30 $ | 2,50 $ | ||
| Claude Haiku 4.5 | Anthropic | 1,00 $ | 5,00 $ | |
| Gemini 3.8 Flash | 1,50 $ | 7,50 $ | Precio desde el 1 de enero de 2027; hasta el 31 de diciembre de 2026 cuesta la mitad | |
| GPT-5.6 Terra | OpenAI | 2,00 $ | 12,00 $ | |
| Claude Sonnet 5 | Anthropic | 2,00 $ | 10,00 $ | Tokenizador que cuenta un 30 % más de tokens |
| Claude Opus 5.5 | Anthropic | 4,00 $ | 20,00 $ | Tokenizador que cuenta un 30 % más de tokens |
Fuentes, consultadas el 22 de septiembre de 2026: precios de la API de Gemini (actualizada el 16 de septiembre), precios de la API de OpenAI y precios de la API de Anthropic. Los euros de los ejemplos usan el cambio de referencia del Banco Central Europeo de ese día: 1 € = 1,1463 $.
Anthropic avisa en su página de precios de que los modelos Claude 4.7 y posteriores usan un tokenizador que produce alrededor de un 30 % más de tokens para el mismo texto. Por eso los cálculos multiplican por 1,3 los tokens de Sonnet 5 y Opus 5.5; Haiku 4.5 usa el anterior. Cada proveedor trocea el texto a su manera, y ese 30 % es el único ajuste que uno de los tres declara en su página de precios.
Faltan a propósito los modelos de gama más alta, como GPT-6 Astra o Claude Fable 5.1, a 10 $ la entrada y 50 $ la salida. Leer una factura o responder sobre un manual rara vez los necesita, y si tu prueba dice lo contrario, la fórmula de abajo sirve igual.
Ejemplo 1: leer 1.000 facturas de proveedor al mes
| Supuesto | Valor | De dónde sale |
|---|---|---|
| Facturas al mes | 1.000 | Ejemplo |
| Páginas por factura | 2 | Ejemplo |
| Tokens por página | 1.500 | Límite bajo de la estimación de Anthropic para PDF (1.500-3.000 por página) |
| Instrucciones y lista de campos | 1.000 tokens | Supuesto |
| Tokens de entrada por factura | 4.000 | 1.000 + 2 × 1.500 |
| Tokens de salida por factura | 800 | Datos en JSON: cabecera y unas diez líneas |
| Llamadas al modelo por factura | 1 | Sin reintentos |
La fórmula: coste al mes = facturas × (tokens de entrada × precio de entrada + tokens de salida × precio de salida) / 1.000.000. Con Sonnet 5 y Opus 5.5, los tokens se multiplican antes por 1,3. El resultado sale en dólares; dividido entre 1,1463, en euros.
| Modelo | € al mes | € por factura | € al año |
|---|---|---|---|
| GPT-5.6 Luna | 1,54 | 0,0015 | 18,42 |
| Gemini 3.5 Flash-Lite | 2,79 | 0,0028 | 33,50 |
| Claude Haiku 4.5 | 6,98 | 0,0070 | 83,75 |
| Gemini 3.8 Flash | 10,47 | 0,0105 | 125,62 |
| GPT-5.6 Terra | 15,35 | 0,0154 | 184,24 |
| Claude Sonnet 5 | 18,15 | 0,0181 | 217,74 |
| Claude Opus 5.5 | 36,29 | 0,0363 | 435,49 |
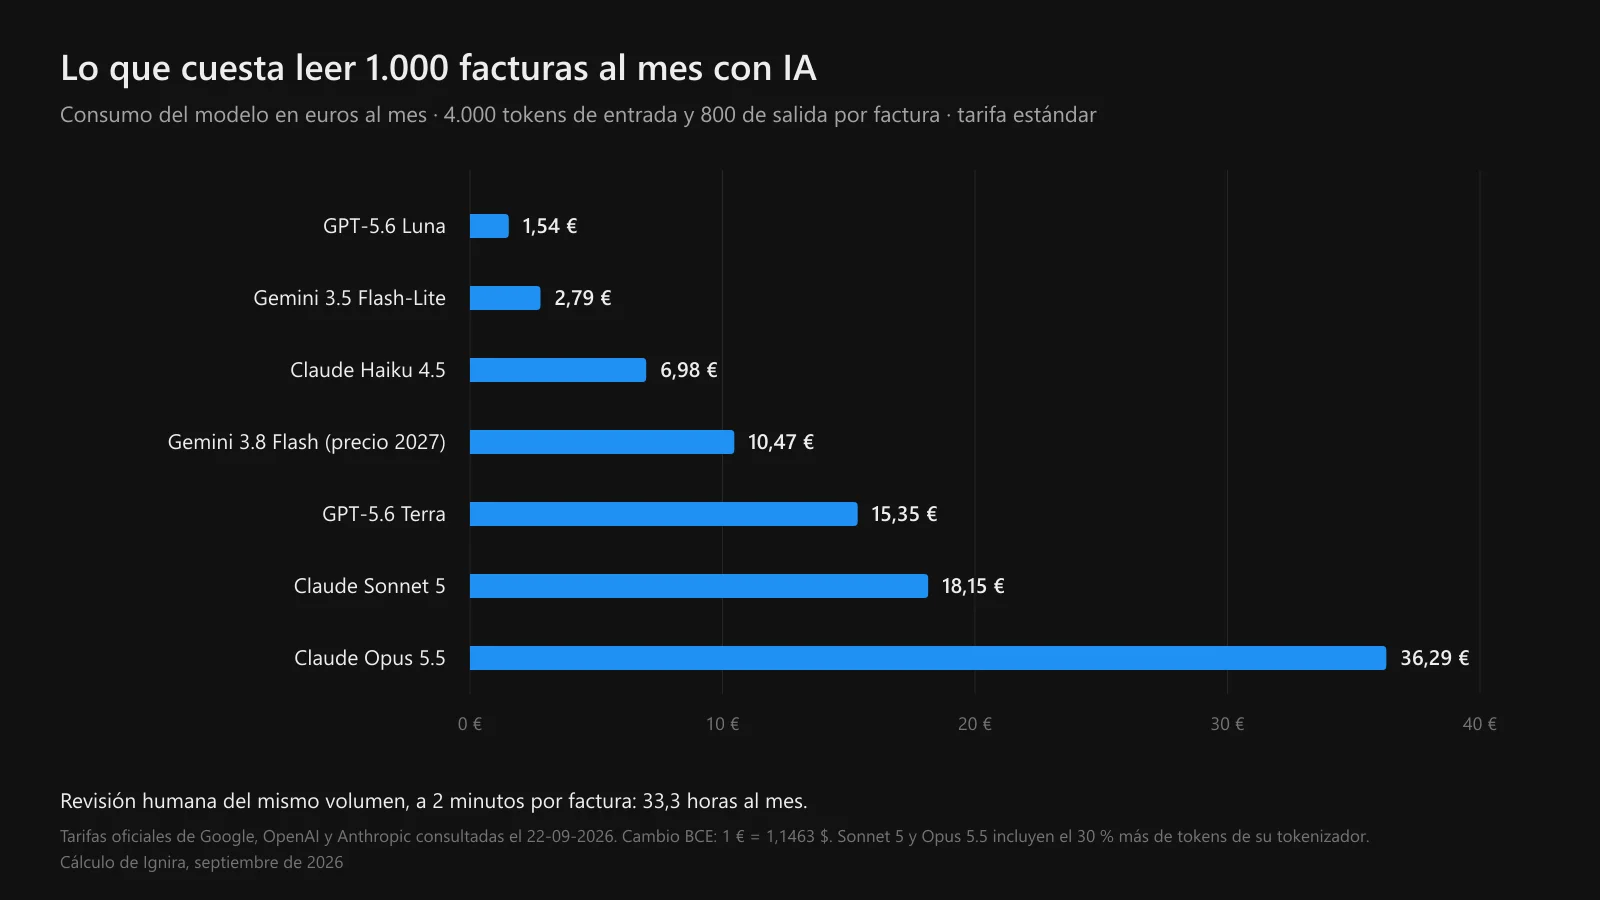
Si tus facturas son densas (3.000 tokens por página y 1.500 de salida), la horquilla pasa a 2,79-65,78 € al mes. En sentido contrario, la documentación de PDF de Gemini cuenta 258 tokens por página y, en los modelos Gemini 3, no cobra el texto que ya viene escrito dentro del PDF, así que con Google la cifra real puede quedar por debajo de la tabla. Mientras dure el precio reducido de Gemini 3.8 Flash, este mismo ejemplo cuesta 5,23 € al mes.
Las facturas no necesitan respuesta inmediata, y los tres proveedores cobran la mitad por procesar en lotes. Con Gemini 3.5 Flash-Lite por lotes, las 1.000 facturas salen a 1,40 € al mes.
Ejemplo 2: 2.000 preguntas al mes a un asistente con tus documentos
Un asistente RAG busca en tus documentos los fragmentos que responden a la pregunta y se los pasa al modelo junto con las instrucciones. Supuestos por pregunta: 1.000 tokens de instrucciones, 5 fragmentos de 800 tokens y 1.000 tokens de pregunta e historial reciente. En total, 6.000 tokens de entrada y 500 de salida.
| Modelo | € al mes (2.000 preguntas) | € al mes (30.000 preguntas, 1.000 al día) |
|---|---|---|
| GPT-5.6 Luna | 3,14 | 47,11 |
| Gemini 3.5 Flash-Lite | 5,32 | 79,82 |
| Claude Haiku 4.5 | 14,83 | 222,45 |
| Gemini 3.8 Flash | 22,25 | 333,68 |
| GPT-5.6 Terra | 31,41 | 471,08 |
| Claude Sonnet 5 | 38,56 | 578,38 |
| Claude Opus 5.5 | 77,12 | 1.156,77 |
Preparar el índice también consume tokens, aunque poco. Con gemini-embedding-2, a 0,20 $ por millón, indexar 1.500 documentos de 4.000 tokens (6 millones de tokens) cuesta 1,05 € una sola vez, y las 2.000 preguntas del mes añaden menos de dos céntimos.
A 1.000 preguntas diarias, los modelos ligeros se quedan entre 47 y 222 € al mes, en la zona del rango de 50-300 € al mes que da nuestro artículo de RAG para ese volumen. Con los modelos medios y altos, la factura del modelo ya supera a la de la infraestructura.
Ejemplo 3: un agente que registra 300 pedidos al mes
Un agente llama al modelo varias veces por tarea: lee el pedido, consulta el cliente, comprueba el stock, prepara el registro, confirma. Cada llamada arrastra lo que las anteriores han ido acumulando. Supuestos: 8 llamadas por pedido, 8.000 tokens de entrada de media por llamada y 400 de salida. Por pedido, 64.000 tokens de entrada y 3.200 de salida: 16 veces más entrada que una factura.
| Modelo | € al mes (300 pedidos) | € por pedido |
|---|---|---|
| GPT-5.6 Luna | 4,35 | 0,0145 |
| Gemini 3.5 Flash-Lite | 7,12 | 0,0237 |
| Claude Haiku 4.5 | 20,94 | 0,0698 |
| Gemini 3.8 Flash | 31,41 | 0,1047 |
| GPT-5.6 Terra | 43,55 | 0,1452 |
| Claude Sonnet 5 | 54,44 | 0,1815 |
| Claude Opus 5.5 | 108,87 | 0,3629 |
Con 300 pedidos la cifra sigue siendo pequeña. El salto está en la escala: cada pedido del agente cuesta entre 8,5 y 10 veces lo que la lectura de una factura, así que el volumen y el número de pasos deciden si el modelo pasa a ser una partida seria.
Lo que cuesta más que el modelo
La factura del modelo suele ser la línea más pequeña del coste de una IA en producción. Las tres que pesan más no salen en ninguna página de precios.
Revisión humana
En el ejemplo de las facturas, si cada una necesita dos minutos de revisión (el mismo supuesto que usamos en la guía para automatizar la entrada de facturas), son 33,3 horas de trabajo al mes. Si además un 5 % se corrige a mano a razón de seis minutos, suma otras 5 horas. El modelo cuesta entre 1,54 y 36,29 € al mes; la revisión, 38,3 horas, casi una semana laboral de una persona.
El objetivo de un proyecto así es bajar esos minutos de revisión, y ahí se nota la diferencia entre modelos. Uno que acierta más campos puede salir más barato aunque su token cueste diez veces más.
Evaluación, al principio y cada vez que algo cambia
Antes de poner nada en producción hace falta una muestra de documentos reales, con los casos difíciles, y alguien que compruebe campo a campo qué acierta el sistema. Esa prueba se repite cuando cambias de modelo o de instrucciones, y los modelos cambian más de lo que parece. La página de precios de Anthropic ya marca como retirados en su API Claude Opus 4.1 y Sonnet 4, y Google duplicará la tarifa de Gemini 3.8 Flash el 1 de enero de 2027. Las tarifas se mueven en los dos sentidos: el precio de lanzamiento de Sonnet 5 pasó a ser el precio estándar.
Mantenimiento e infraestructura
Un proceso automatizado necesita vigilancia, ajustes cuando un proveedor cambia el formato de sus facturas y alguien que responda cuando algo falla. En el mercado español, ese mantenimiento se mueve entre 100 y 400 € al mes para una automatización. Un asistente RAG añade entre 30 y 100 € al mes de infraestructura (servidor, base de datos vectorial, almacenamiento) y entre 200 y 800 € al mes de operación, según el nivel de servicio acordado.
Qué hace subir o bajar la factura del modelo
- Elegir modelo. En el ejemplo de las facturas, el más caro de los siete cuesta 23,6 veces lo que el más barato. Se prueba primero el ligero y se sube solo si la evaluación lo pide.
- Procesar por lotes. Google, OpenAI y Anthropic cobran la mitad por las peticiones que aceptan esperar. Casi todo lo administrativo puede esperar unas horas.
- Cachear lo que se repite. Las instrucciones y los documentos que viajan en cada llamada se pueden cachear. Los tres proveedores cobran la lectura desde caché en torno a una décima parte del precio normal de entrada; la escritura o el almacenamiento de esa caché se paga aparte.
- Dónde se procesan los datos. OpenAI cobra un 10 % más en sus endpoints de residencia de datos para modelos lanzados desde el 5 de marzo de 2026. Anthropic indica el mismo 10 % para los endpoints regionales de Amazon Bedrock y Google Cloud frente a los globales.
- El nivel gratuito, nunca con datos reales. La página de precios de Gemini indica que el contenido del nivel gratuito se usa para mejorar los productos de Google; el del nivel de pago, no. Con datos de clientes o empleados, nivel de pago y contrato de tratamiento.
Ayudas públicas para IA en 2026: Kit Consulting está cerrado
El programa estatal que más se cita, Kit Consulting de Red.es, aparecía el 22 de septiembre de 2026 como «convocatoria finalizada» en el portal Acelera pyme, y la página no anunciaba una nueva. Iba dirigido a pymes de 10 a 249 empleados, con bonos de 12.000, 18.000 o 24.000 € según el tamaño.
Su catálogo de servicios fijaba 6.000 € para el asesoramiento en inteligencia artificial. Era un servicio de consultoría para decidir qué hacer; no pagaba la construcción ni el uso del modelo. Si alguien te presenta un proyecto de IA financiado en 2026, pide el nombre de la convocatoria y comprueba en la fuente oficial que está abierta y qué gasto cubre.
De dónde salen las cifras de este artículo
Los rangos de implantación y mantenimiento son una lectura del mercado español para proveedores que entregan código, pruebas y mantenimiento. Son los mismos que publica el resto del blog y no son un estudio con muestra ni una tarifa de Ignira. Sirven para situar un presupuesto, no para cerrarlo.
Los costes de uso son verificables. Salen de las tarifas oficiales de Google, OpenAI y Anthropic consultadas el 22 de septiembre de 2026, en su nivel estándar de pago, pasadas a euros con el cambio del Banco Central Europeo de ese día. Los supuestos de tokens están en las tablas de cada ejemplo, y la cuenta se hizo con un script, no a mano.
Si tus facturas tienen cinco páginas o tu asistente recupera diez fragmentos por pregunta, cambia el supuesto y rehaz la cuenta con la fórmula del primer ejemplo. Las tarifas cambian a menudo: la fecha de consulta es parte del dato.
Pide el coste de uso por escrito antes de firmar
Un presupuesto de IA completo separa tres cosas: la implantación, el mantenimiento y el consumo del modelo. Para la tercera, pide por escrito qué modelo se usará, dónde se procesan los datos, cuántos tokens se estiman por documento o por pregunta, cuánto sale al mes con tu volumen y a nombre de quién está la cuenta del proveedor de IA. Pregunta también qué pasa cuando el modelo elegido se retire.
En la ficha de IA y automatizaciones lo tenemos como condición: qué IA usar, dónde procesa los datos y sus costes de uso se acuerdan antes de contratar. Si tu caso es la entrada de facturas, el alcance concreto está en automatización de facturas de proveedor. Trabajamos desde Torrelavega con empresas de toda la región, y cómo lo planteamos está en inteligencia artificial en Cantabria.